
Durante los últimos dos años, casi todo el debate sobre video generativo ha girado en torno al prompt: cómo escribirlo, cómo afinarlo, cómo lograr que un modelo entendiera una idea abstracta. Sin embargo, si observamos lo que los creadores publican en realidad en la actualidad, el patrón dominante es otro.
La mayoría de creadores no parte de una descripción textual, sino de una imagen ya existente: una fotografía, una ilustración, un fotograma rescatado de un archivo antiguo. El texto describe; la imagen decide.
Este desplazamiento, silencioso pero constante, está redefiniendo cómo se produce contenido audiovisual fuera de los grandes estudios.
Por qué la imagen se ha impuesto al prompt
El problema de la generación puramente textual nunca fue la calidad del render, sino la reproducibilidad.
Dos ejecuciones del mismo prompt devuelven dos mundos distintos: otra luz, otro rostro, otra paleta. Para una pieza suelta eso resulta aceptable, pero para una serie con identidad propia, es directamente inviable.
Una imagen de partida elimina esa ambigüedad de raíz. El encuadre, la textura, el color y la identidad del sujeto dejan de ser interpretaciones para convertirse en datos fijos. El modelo ya no inventa la escena: la pone en movimiento.
Se trata de una diferencia conceptual pequeña pero de una diferencia práctica enorme, porque traslada el control creativo desde la redacción hacia la referencia visual, que es el terreno natural de cualquier persona con formación en fotografía o diseño.
En ese contexto se sitúan las plataformas que permiten convertir foto a video online desde Pollo AI, donde el sistema no depende de un único motor sino que reúne varios modelos de generación bajo una misma interfaz y orienta cada imagen hacia el que mejor resuelve su tipo de movimiento.
El material original conserva sus bordes, su grano y su profundidad de campo, y la pieza sale acompañada de una capa sonora con ambiente y efectos ya integrados, de modo que no exige una fase posterior de montaje para ser publicable.
El detalle es donde se rompe la ilusión
Cualquiera que haya animado imágenes con IA conoce el punto exacto donde el efecto falla. No es el movimiento general, que suele resolverse bien, sino los detalles pequeños: las manos, los reflejos, la tipografía impresa sobre un envase, los patrones repetitivos de una tela.
Ese es el criterio técnico que realmente separa a los modelos entre sí, mucho más que la duración máxima o la resolución nominal. Un plano de cuatro segundos con las texturas intactas sirve; uno de diez segundos donde el rostro se deforma a mitad de trayecto no sirve para nada, por espectacular que sea el resto del encuadre.
La consecuencia práctica es que la fidelidad al original vale más que la ambición del movimiento. Los creadores con más oficio piden desplazamientos contenidos —una deriva lateral, una respiración, un parpadeo de luz— precisamente porque saben que el margen de error crece de forma exponencial con la amplitud del gesto.
La agregación de modelos responde a un problema real
Hay una razón poco discutida para que las plataformas agreguen varios modelos en lugar de perfeccionar uno solo: ningún motor único destaca en todas las categorías de movimiento.
Algunos manejan bien la figura humana y fallan con líquidos. Otros resuelven paisajes y colapsan ante superficies metálicas.
Un creador que trabaja con material heterogéneo —retrato, producto, ilustración, arquitectura— necesitaría suscribirse a tres o cuatro servicios distintos y aprender las manías de cada uno.
Que la elección del motor ocurra por debajo de la interfaz no es un detalle cosmético. Elimina una capa entera de conocimiento técnico que, hasta hace poco, era el principal obstáculo de entrada para ilustradores y fotógrafos interesados en el video generado por inteligencia artificial.
El audio dejó de ser un paso posterior
Otro cambio menos visible tiene que ver con el sonido. Durante mucho tiempo, la generación de video devolvía piezas mudas que había que sonorizar en otra aplicación, con librerías de licencia dudosa y un ajuste manual de sincronía.
Incorporar música y ambiente en el mismo proceso no mejora la calidad artística por sí solo, pero elimina el paso que más abandonos provoca. Buena parte de las animaciones que nunca llegan a publicarse mueren precisamente ahí, en la carpeta de exportaciones sin sonorizar.
Dónde encaja el video con locución y presentador
Conviene distinguir dos familias de herramientas que a menudo se confunden. Una anima material visual existente; la otra construye piezas explicativas a partir de texto.
En esa segunda categoría, Vidnoz AI Gratis funciona como una alternativa complementaria a Pollo AI más que como un sustituto.
Su planteamiento parte de un asistente que ordena el contenido de una URL, un PDF o un documento y devuelve un guion gráfico con narración ya montada, apoyado en presentadores virtuales con gestualidad y microexpresiones creíbles, clonación de voz para mantener el timbre real de quien firma el contenido y un editor con plantillas, transiciones y efectos para el ajuste final.
Para un tutorial hablado o una pieza divulgativa, ese camino resulta más directo. Para animar un archivo fotográfico, no aporta nada.
Cómo construir una secuencia animada desde un banco de imágenes
Elegir el fotograma con espacio de movimiento
No toda fotografía admite animación.
Las que funcionan tienen profundidad —un primer plano, un fondo, aire entre ambos— y algún elemento susceptible de moverse: humo, tela, agua, cabello, luz.
Una imagen frontal, plana y perfectamente simétrica suele devolver un resultado rígido. Descartar en esta fase ahorra más tiempo que cualquier ajuste posterior.
Describir el movimiento, no la escena
El error más común consiste en redactar la instrucción como si el modelo no viera la imagen. La escena ya está resuelta: lo único que hace falta indicar es qué se desplaza, en qué dirección y a qué ritmo.
Instrucciones cortas y físicas —»la cámara retrocede lentamente, el humo asciende hacia la derecha»— rinden mejor que párrafos descriptivos.
Encadenar planos manteniendo la coherencia
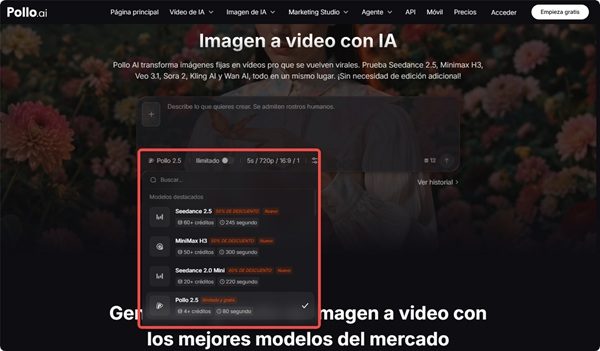
Para una secuencia de varios planos, conviene generar todos los fragmentos a partir de fotografías de la misma sesión, con idéntica temperatura de color y misma óptica.
Al convertir foto a video online con Pollo AI partiendo de un conjunto homogéneo, los planos resultantes comparten textura y grano, y el montaje final no delata los cortes.
Mezclar fuentes distintas es lo que produce esa sensación de collage que arruina piezas técnicamente correctas.
Revisar el sonido antes de exportar
Escuchar la pieza con auriculares y sin mirar la imagen revela desajustes que la vista perdona.
Si el ambiente sonoro sugiere una escala distinta a la del encuadre —un espacio amplio sobre un plano cerrado, por ejemplo—, la incoherencia se percibe aunque el espectador no sepa nombrarla.
Lo que cambia para quien ya sabe mirar
La conclusión incómoda para el sector es que el video generativo no premia a quien mejor escribe prompts, sino a quien mejor fotografía. La calidad del punto de partida sigue determinando el techo del resultado.
Eso reordena el mapa de ventajas. Fotógrafos, ilustradores y directores de arte, que llevaban dos años observando esta tecnología con cierta distancia, resultan ser el perfil mejor posicionado para explotarla, porque el activo escaso vuelve a ser la imagen.
Tanto si un estudio incorpora Vidnoz AI Gratis para sus piezas explicativas como si organiza su producción visual alrededor de la animación de archivo, el criterio decisivo continúa siendo el mismo de siempre: saber qué merece moverse y qué está mejor quieto.
Sin comentarios